
La carte du système : Architecture kreek en trois schémas

On parle beaucoup d'architecture. On en montre très peu.
C'est logique. Le code d'un projet est souvent visible, mais son architecture reste dans la tête de celui qui l'a écrite. Il faudrait la dessiner, la commenter, assumer les choix. Et surtout, accepter que quelqu'un vienne dire que c'est mal foutu.
Alors allons-y.
Voici l'architecture de Kreek, en trois schémas. La vue d'ensemble, l'intérieur d'un contexte, et le trajet d'un événement. À la fin, je dirai ce que ces schémas cachent, parce qu'un beau diagramme est toujours un peu un mensonge.
Premier schéma : la vue d'ensemble
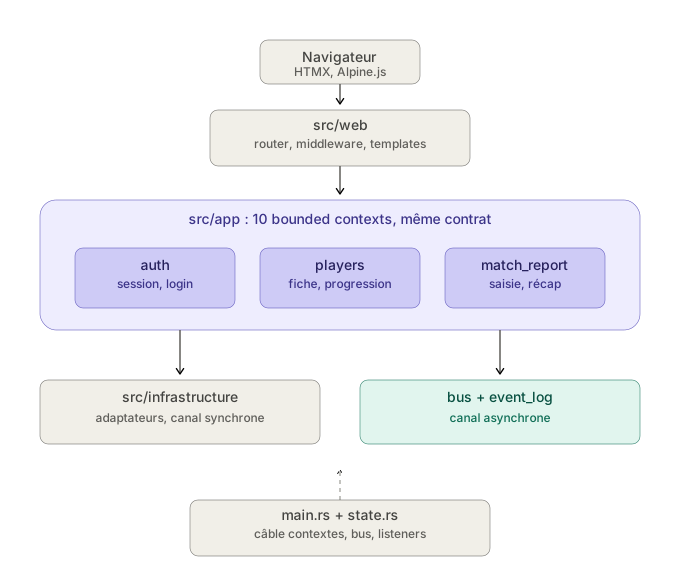
Le navigateur attaque la couche web transverse, qui route vers les bounded contexts (une dizaine à l'heure ou j'écris ces lignes). Ces contextes communiquent entre eux par deux canaux seulement : les adaptateurs de la couche infrastructure en synchrone, les bus d'évènements en asynchrone. Le composition root branche l'ensemble. Ce qu'il faut retenir en trente secondes : les contextes ne se connaissent pas.
Chacun expose exactement le même contrat : un router.rs, un context.rs, un ports.rs. Vu de l'extérieur, ils sont interchangeables.
Et aucun n'importe un autre. Jamais. Ce n'est pas une règle de politesse, c'est une contrainte vérifiée automatiquement avant chaque commit par un script qui refuse de passer si un contexte va fouiller chez son voisin (le script check-arch, un des pivots de mon harnais)
Du coup, il leur faut bien deux façons de communiquer. Exactement deux, et c'est toute l'histoire de ce schéma.
Le canal synchrone, à gauche. Quand players a besoin du catalogue de compétences qui appartient à réferences, il ne va pas le chercher lui-même. Il déclare un besoin dans son ports.rs, et quelqu'un d'autre l'implémente. Ce quelqu'un vit dans src/infrastructure/, une couche à part, organisée par contexte consommateur.
Pourquoi dehors ? Parce qu'un adaptateur est le seul objet du système qui connaît deux contextes à la fois. Il ne peut donc appartenir à aucun des deux. Le mettre dans l'un ou dans l'autre, c'est recréer la dépendance qu'on vient d'interdire.
Dit autrement si un jour je veux réimplémenter ce port pour en faire une API rest, et migrer vers du micro-service, le code est prêt.
Puis, vient :e canal asynchrone, à droite : les bus d'événements. C'est le troisième schéma.
Et tout en bas, le main.rs. Le seul fichier autorisé à tout connaître. Dans une architecture qui interdit les dépendances croisées, il faut bien un endroit où l'on câble tout ensemble. Sa complexité n'est pas une dette, c'est le prix concentré de la pureté de tout le reste.
Deuxième schéma : l'intérieur d'un contexte
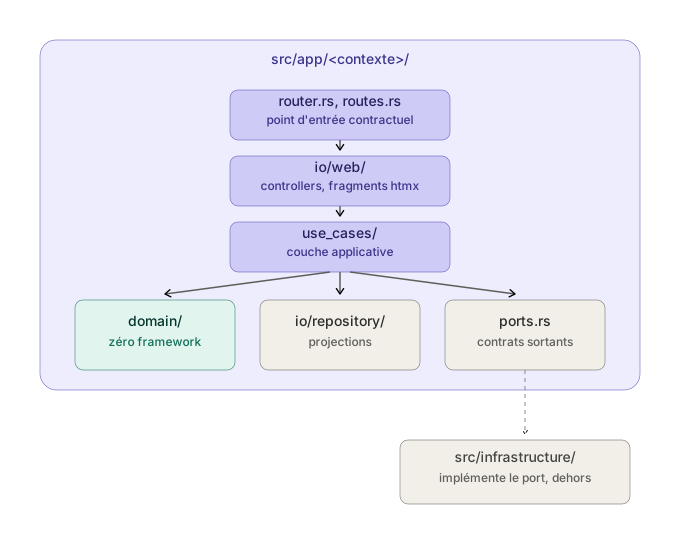
Le découpage interne d'un contexte : router.rs comme point d'entrée, io/web pour les controllers, use_cases comme couche applicative, puis le domaine pur, les projections et les ports.
L'implémentation des ports vit hors du contexte, dans src/infrastructure. src/app/<contexte>/ router.rs, routes.rs point d'entrée contractuel io/web/ controllers, fragments htmx use_cases/ couche applicative domain/ zéro framework io/repository/ projections ports.rs contrats sortants src/infrastructure/ implémente le port, dehors Le même découpage, dix fois. C'est ce qui rend le projet navigable, pour moi comme pour l'assistant qui travaille dessus : quand la structure est uniforme, on devine où va un fichier sans avoir à chercher.
Au centre, domain/. L'agrégat, ses événements, ses value objects, ses erreurs. Et une règle : zéro import de framework. Pas d'axum, pas de sqlx, pas d'askama. Le domaine ne sait pas qu'il tourne dans une application web.
Cette règle est vérifiée mécaniquement. Un grep sur les imports des dossiers domain/, et le script échoue si quelqu'un a laissé passer un use sqlx. Ce n'est pas sophistiqué. C'est efficace.
Autour, les adaptateurs dans io/. Le web qui reçoit les requêtes, le repository qui lit les projections, les listeners qui réagissent aux événements. Ils dépendent tous du domaine. Le domaine ne dépend de personne.
Et le détail qui mérite qu'on s'arrête : ports.rs est dans le contexte, mais son implémentation est dehors. Le contexte déclare ce dont il a besoin. Il ne sait pas qui le lui fournira, ni comment. C'est ce qui permet de le tester seul, avec un faux port en trois lignes.
Troisième schéma : le trajet d'un événement
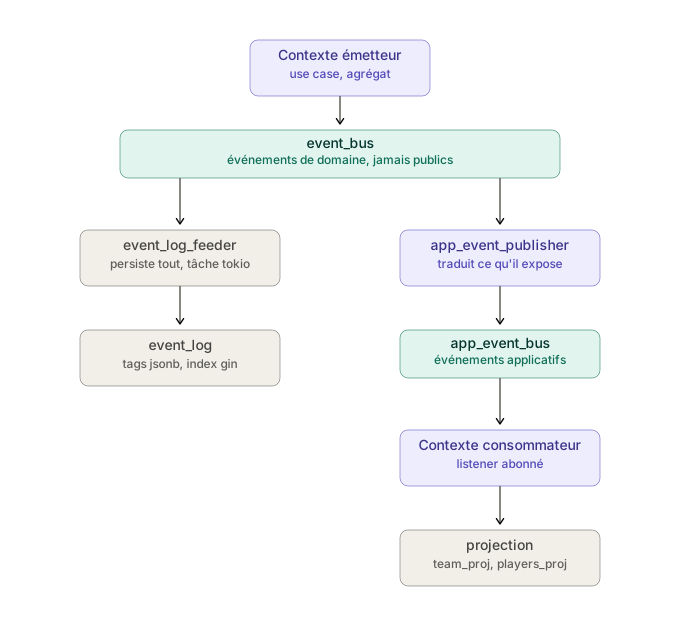
La règle qui gouverne tout : un événement de domaine ne franchit jamais une frontière de contexte.
Regardons ce qui se passe. Un cas d'usage exécute une décision métier, l'agrégat produit un événement, et cet événement part sur un bus d'évènement local. Deux abonnés s'en saisissent, en parallèle.
Le premier, event_log_feeder, persiste. Tout, sans filtre, dans une table unique. Un global_position qui s'incrémente, un payload en JSONB, et surtout une colonne tags avec un index GIN. C'est ce qui permet de relire l'historique par intersection de tags plutôt que par identifiant d'agrégat, mais c'est un autre article.
Le second est plus intéressant. Chaque contexte s'abonne à son propre bus de domaine, et traduit ce qu'il accepte de rendre public en événement applicatif. Celui-là part sur app_event_bus, où les autres contextes l'écoutent.
Dit autrement : chaque contexte décide de ce qu'il expose. Ses événements internes restent internes. Ce qui traverse la frontière, c'est une version publique qu'il a choisie et qu'il maîtrise. Cette notion est assez importante et permet d'avoir une couche d'indirection qui évite les couplages forts entre le détail d'un évènement de domaine, et l'utilisation qui en est faite à l'extérieur du domaine en question.
c'est un peu tricky dit comme ça, mais l'app_event est en quelque sorte une acl d'évènement de domaine.
Ce n'est pas une convention de documentation. C'est un mécanisme qui tourne, en tokio, dans le processus.
Ce que ces schémas cachent
Maintenant, la partie honnête.
Ce dessin n'est pas un plan. C'est une reconstruction.
Je n'ai pas conçu cette architecture puis codé. J'ai codé, je me suis pris des murs, et la structure a émergé de ces murs. La couche src/infrastructure/ n'existait pas au départ : elle est née le jour où la règle d'isolation m'a interdit de laisser les adaptateurs là où je les avais mis. Un des contextes du schéma n'aurait jamais dû exister, et je vais le supprimer. Des tables de projection ont été renommées deux fois, et ce renommage a produit des bugs qui ont dormi des semaines.
Un schéma propre est toujours une histoire racontée après coup, avec le bénéfice de savoir comment elle finit.
Et il cache deux fragilités.
La première : la persistance est asynchrone. Le feeder tourne dans une tâche détachée. Si l'écriture dans l'event log échoue, le cas d'usage a déjà répondu avec succès. On logge une erreur, et c'est tout. Sur le schéma, la flèche vers event_log a l'air aussi solide que les autres. Elle ne l'est pas.
La seconde : le canal a une capacité de 256 messages. Un abonné trop lent se fait distancer, et les messages qu'il a ratés sont perdus. Le code le détecte et logge un avertissement. Il ne les rejoue pas.
Aucune flèche ne dit ça. Les flèches ne disent jamais ça.
C'est pour cette raison que je publie les trois schémas et cette dernière section. Un diagramme d'architecture, c'est une carte.
Utile pour se repérer, muette sur l'état des routes.
Commentaires ()